2013年3月5日火曜日

[#Cloud #クラウド ] OpsWorksとAWSバイオドームの関係?AWSの発表したOpsWorksの本当の意味と、今後のIaaS市場の流れ


一言で表現すると、AWSの今後向かっている方向は、バイオドームである、と評されている。様は全てのIT運用管理をAWSの提供するサービスで閉じてしまおう、という事である。従来のAWSの持っていた、3rd partyベンダーとのエコシステムを少しずつであるが、壊しつつある、という考え方であり、業界としては大きな関心をもって注目すべきである、と言う意見が多い。

OpsWorksとは何か?
OpsWorksは、AWSが提供する自社のインスタンスを操作するためのAPIと、オープンソースで提供されているChef(ソフトウェアのインストールと初期化を管理するオープンソース)が合体した様なものです。OpsWorksで構築するのは、AWSで作成するインスタンスや関連するリソースで、従来AWSのコンソールで管理していたリソースをプログラミング出来る、という事です。書いたコードは、Stack(スタック)と呼ばれます。要するに、StackはAWS上のアプリケーション、という事です。DevOpsの狙いは、従来サーバやインスタンスの操作が中心だったAWSの利用を上位のアプリケーションのレイヤーに移行し、システム全体のアプリケーションライフサイクルを管理できるような操作環境を作り上げる事です。この技術、元はAWSが行った数少ない買収の一つ、Peritorという会社から買い上げたScalarium、という製品をベースにした物です。

パートナーにとってどういう意味を持つか?
この発表は、今後のAWSパートナーネットワークに少なからずとも影響を及ぼすもの、と考えられます。大手のSIはまだあまり大きな心配は必要としていませんが、AWSマーケットプレイス等に自社の3rdパーティ製品を掲載していて、尚かつクラウド管理等、AWSの管理機能をエンハンスする様な内容のソリューションを提供するベンダーは今後AWS本体のこういったサービスと直接競合する可能性が高くなっている。OpwWorksに限らず、最近の新機能の発表の一連は、明らかにAWSが自社のサービスを従来のIaaSの閉じた物から上位の方向に上り始めている、という事を示す物である、という理解が業界内で広がり始めている。

業界に対する影響は?
まず、OpsWorksは無償で提供されるので、Chef利用者を中心としたコミュニティが育成されるもの、と想定されます。Chefで作った財産は、AWS上に移植、運用、管理される事になり、かなりのリソースが蓄積されるもの、と考えられます。また、このリソースをベースに、組み合わせやエンハンスを通して新たなライブラリが構築される事も考えられます。

逆に、最大の問題として最も危惧されるのは、AWSアーキテクチャへのロックインです。勿論Chef自体のコード(レシピー)はChefが稼働するプラットホームなら全て互換性が保たれますが、実際のスタック内の記述はAWS APIそのもので、他のIaaS(プライベート、パブリック含め)では稼働する事はまずあり得ません。

AWSバイオドーム内で作ったOpsWorksのStackは最初はうまく動くかもしれませんが、アプリケーションライフサイクルが進むにつれ、だんだんと問題が表面かしてきます。

他のクラウドプロバイダにとってどういう意味を持つのか?
IaaSクラウドプロバイダーは、AWS EC2やS3に同等のコンピューティングプラットホームサービスを提供する事から始まります。今では、かなりのベンダーがこの事業に参画し、市場が賑わってます。加えて、仮想ストレージ、仮想ネットワーク等の付加価値サービスも提供し始めていますが、同時に価格面での競争が激化しており、開発投資にそんなに比重が置けなくなっている現実もあります。市場全体がこのようなCatch-Upの動きを見せる中、AWSはさらに上位のレイヤーのサービスの実現に力を入れてきました。下記が最近だけでも登場しているサービスのリストです。

Route53:AWSのDNSサービス
RDS:AWSのクラウド上のRDBサービス
RedShift:AWS上のデータウェアハウスサービス
CloudFormation:AWSのもう少し低レベルでのAWSインスタン管理ツール
Elastic Beanstalk:オートスケーリングに特化したAWSインスタンスの管理運用サービス 

AWSの現在提供するサービスラインに追いつくにもまだまだ新規サービスを作り出す必要があるのが現状です。
OpenStackの動きは顕著なものがありますが、こちらもまだまだ開発(もしくは買収攻勢)に投資を続ける必要がある様です。 

最後に:VMWareがPuppetに投資をした事がいろいろな意味でこの動きを生んだ、という分析もあります。最近では初期の投資に加えて、さらに$30Mの追加投資を行った、という事です。これは、構図で言うと、プライベートクラウド業界に於けるVMWare、パブリッククラウド業界に於けるAWS、という棲み分けになります。今後も、この関係柄は続くもの、と想定されており、いわゆる冷戦状態を他のクラウドベンダー、SIベンダーがうまく立ち回る、という市場が形成されて行くもの、と想像されます。


Ippei Suzuki
tel:  (714) 930-5000
Twitter = CloudNewsCenter
Skype = ippei.suzuki

2013年2月9日土曜日

{#BigData #ビッグデータ ]ビッグデータとイン•メモリ演算による分析事業に対する注目

ビッグデータとイン•メモリ演算による分析事業に対する注目

記事=www.cio.com/article
投稿者=Allen Bernard, Managing Director @ CIOUpdate.com
投稿日=12/6/2012

最近のビッグデータ関連のニュースは多く、特にインメモリ(In-Memory)分析や、インメモリ技術、という言葉と連携して使われるケースが多い。昨今のサーバ仮想化の技術や、クラウド技術というのは、考えようによってはメインフレームから培われた仮想化の技術の発展系であって、本質的に時代を変えていく技術として注目されているのは、格段に安くなったDRAMを利用しインメモリ技術を利用したビッグデータ事業である、と言える

予測分析技術に特化したオープンソース言語である、Rの開発者である、Revolution Analytics社のDavid Smith氏は下記のコメントを述べている。
"In-memory has been around a long, long time, but now that we have big data, it's only the availability of terabyte (TB) systems and massive parallel processing [that makes] in-memory more interesting."
「インメモリ技術はかなり前から存在してます。ただ、ビッグデータの登場によって、その技術とテラバイト級の大型並列処理システムの組み合わせがインメモリ技術を大きく成長させる事が出来る。」

SAP HANAや、Oracle Exalyticsの様な、ビッグデータを利用したデータ分析アプリケーションを一つのハードウェアシステムとして組み込んで提供するシステムが登場している。HANAに関しては、Amazon Web Service上でのサービスや、SAPのNetWeaverプラットホーム等でも提供されている。

一方では、データ分析事業のプロバイダーである、SAS , Cognos, Tableau, Jaspersoft社等は自社製品の性能向上を狙い、In-Memory型の製品バージョンを発表している。ただし、Terracotta社のGM、Gary Nakamura氏によると、どの製品も(自社製品も含め)、活用出来るメモリー量もハードウェアではなく、製品自体のソフトウェア的な限界があり、厳密に言うとIn-Memory型のソリューションではない、と厳しく指摘している。

In-memoryソリューションは、データ分析業務の性能改善に寄与する

「要は、一つのプラットホームのフラッシュメモリ上に、データ、さらにそのデータモデルも含めて搭載し、高速で処理する事が出来る、という事が出来るか否かである。」とOpera Solutions社のShawn Belvins氏が述べている。

ビジネス的な観点からも、リアルタイムで大量のデータからビジネス上の決断を促す情報を如何に早く見出すかが重要であり、そこにIn-Memory技術への期待が集まっている。

NewVantage Partners社のPaul Barth氏は、
「In-Memory分析は高速な検索機能によって実現する」
と述べている。特定の地域において、青い自動車に乗っている人の郵便番号等、いろいろな項目同士の関連性を検索機能を駆使する事によって発見する、という作業である。

こういった、関連性を引き出そうとした時に、様々な形でデータを抽出し、関連性を見出すべく比較、分析が行われる。とある条件でデータをディスクから引き出すたびに大量のデータのI/Oが生じ、これがシステム全体の遅延を有無。すべてIn-Memoryで処理する事によって、この遅延を削減する事がポイントである。

データ解析/分析を行う場合、特に企業で戦略的なデータBIを行う際には、母体デーアに対して、様々な角度から上記のデータ抽出検索、分析が繰り返される。回数が多ければ多い程、データ分析を行う時にのスピードの重要性が増してくる。


High-Frequency, Low-Computation Analysis—For Now

今日のビッグデータ分析は、上記のデータ処理によるディスカバリー業務である、と言える。ただし、ビッグデータにおいては対象となるデータ、レコードの数が膨大な量になる事、尚かつ、それを効率よく、高速に処理を行うためにはディスクを使わず、すべてメモリ上の処理で対処する事が必要になってくる。

Facebookにおいて、例えば写真をアップロードすると、ほぼ同時に顔にタグ情報が自動的についてくる機能がある。Facebookは写真がアップされると同時に、写真上の顔一つ一つに対して顔認証のアルゴリズムを走らせ、特徴点を抽出した小さなデータ(40MBの写真に対してタグは40B程度)を生成し記録する。このデータはシステム内の特定のエンジンに移され、顔の認証を行い、名前を特定する。その後は、関係するアカウントに「写真上であなたがタグされました」、とメッセージを発信する。

この一連の処理は、ビッグデータならではの規模で初めて実現する機能である。また、In-Memory分析があるからこそ、この処理を一分に数万回に処理する機能が実現する。大抵のプログラマーは、Javaの制限があるために、100MB以上のデータをIn-Memoryキャッシュに搭載する人は少ない。メモリ上のデータを増やそうとすると、Javaの仮想エンジンを色々とチューニングする必要が生じる。それによって、システムはさらに遅くなる事もある。

現在、In-Memory分析は、高トラフィックで、演算負荷の少ないアプリケーションに向いている。ただ、プラットホーム上に数TB規模のDRAMもしくはフラッシュメモリを確保出来るようになると、アプリケーションの可能性がぐっと高まってくる。IT業界において、こういった高度な分析ビジネスに対するニーズは確実に存在し、分析対象のデータも大量に生成されている中、それを実現するテクノロジーの進歩が待たれている状況である。

テクノロジーが先に登場し、業界があとからそれをビジネスに適用する、という従来のITの業界モデルと異なり、ビッグデータの業界は既に対象となるデータ、そしてそれを高度な分析に利用したい、というニーズが確実に存在する中、従来のSQL型のデータベースインフラから新しいNoSQL/Mapeduce型のインフラに移行しつつあるのが今日の姿である、と言える。ハードウェア的な制限(メモリのコスト、等)が急激に亡くなりつつある状況の中、上記のニーズに対応出来るテクノロジーが登場した瞬間に、急激に市場が立ち上がって成長する事も予測する事が出来る。この急激な波にうまく乗れるかどうかが、企業の成長の分かれ目になる可能性もある。


Ippei Suzuki
tel:  (714) 930-5000
Twitter = CloudNewsCenter
Skype = ippei.suzuki

2013年2月2日土曜日

[#BigData #ビッグデータ ] ビッグデータに関する市場統計情報: クラウドと切っても切れない状況

ビッグデータに関する市場統計情報

記事=www.cloudtweaks.com
投稿者=Cloudtweaks
投稿日=1/2/2013

宇宙的なデジタル情報の広がり

デジタルユニバース、とはグローバルで人間はどれだけデータを今日まで蓄積しているのか、という統計。2005年にはわずか130エクサバイト(ギガバイトの10億倍)だったデータは、どんどん蓄積され、2012年には2,837エクサバイト、2015年には8,591エクサバイト、2020年には40,026エクサバイトになる見込み。

各年ごとのデータ量増加率は;

2005 è 2010 = 9.44倍(年率=1.57倍)
2010 è 2012 = 2.31倍(年率=1.52倍)
2012 è 2015 = 3.02倍(年率=1.45倍)
2015 è 2020 = 4.65倍(年率=1.36倍)

特に経済成長国での増加が顕著

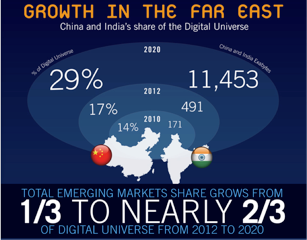
2020年までには、すべてのデジタル情報の29%が中国とインドで占められる、という予測。これは昨年の10%から比較すると大きな成長であり、年成長率、1.522倍に相当する。国レベルでデジタル化が進むと、人口が多いため、絶対量が急激に成長する、という現れである、と言える。

2012年のデジタル宇宙の暗黒領域

この図は、2012年に存在する2837エクサバイトのデータの内、実際に役に立つべく分析が行われているのは1%にも満たない、という事を示している。

分析する事によって価値が出てくる様々なデータの種類を分類すると、

監視カメラや監視装置、等の記録情報:44%
医療機器や内蔵機器等の情報:20%
データ処理機器からのデータ(ログ等):25%
娯楽関係やソーシャルメィア:10%

M2Mの領域に属するデータの量が非常に多く、分析もされず大量のデータが捨てられている、という状況が見える。

ビッグデータ技術に取っては、その機能を多いに発揮出来る分野である。


デジタル宇宙の情報は殆ど守られていない

2012年のデジタル情報は、その多くが守られておらず、悪用される危険性をはらんでいる。特に経済発展国でのデータが守られていないケースが多く、情報セキュリティの徹底が必要となっている。


2020年に於ける、カテゴリー別、情報セキュリティDigitalの分類

情報セキュリティ、といっても、保護をするべきレベルがいくつかあり、その情報の性格によって保護する手法を決める必要がある。全体の約半分がセキュリティを必要としている情報であり、その内訳は下記の通り:

プライバシーの保護を行う程度で十分な情報(YouTubeでのeメールアドレス等)=15%
コンプライアンス上、保護する事が法的に要求される情報(企業内のeメール等)=5%
ID情報等、成り済まし犯罪に利用される可能性のある情報=12%
機密情報、顧客リスト、等、持ち主等が機密情報として守りたい情報=6%
金融情報、需要な個人情報、医療情報、等非常に気密性の高い情報=6%


クラウドで管理されるデジタル宇宙

こういった大量のデータに対して、クラウドコンピューティングは非常に経済的に、かつ有効なストレージソリューションを提供する、という事がデジタル宇宙のデータの補完先の推移を見てわかる。2020年までにはかなりの量のデジタル情報がクラウド上で管理される事になる、という予測である。

逆に、クラウドコンピューティングが無いと、こういった大量のデータの管理が事実上不可能になる、という事も言える。


クラウド上で管理されるデジタル情報の種類(2020年)

クラウド上で管理される情報の種類は、大量に保管出来る事だけではなく、多くは色んなデバイスからアクセス出来る、という利点も会って利用されるケースが多い。特に、エンターテイメント関連のデータ(映画、音楽、写真、等)は多くクラウド上で管理される事が今後多くなる事が予測されている。

また、地域別には、やはり総人口が絶対的に多い、中国、インド等での利用が非常に大きくなる事が予測されている。


これだけ、クラウド上での大規模データの管理/運用が多くなってくるとなると、それを管理/分析するデータベースエンジン、この場合はビッグデータ技術が中心になると考えられるが、さらにデータを利用するアプリケーションも、クラウド上で展開される方向になる事が多いに考えられる。これからのビッグデータのビジネスも、クラウド上で展開されるモデルが中心になる、という事が考えられるので、ビジネスもそのようなモデルで進める必要がある、と言える。

2013年1月26日土曜日

[#BigData #ビッグデータ ] ビッグデータの本質な価値はデータ分析より自動化にある、という考え方

ビッグデータの本質な価値はデータ分析より自動化にある、という考え方

記事=http://gigaom.com/2013/01/02/why-big-data-might-be-more-about-automation-than-insights/
投稿者=Derrick Harris, technology journalist
投稿日=1/2/2013

New York Timesの2012 年末の記事、" Sure, Big Data Is Great. But So Is Intuition."において、"ビッグデータバブル"の懸念が紹介されている。これは、人間が本来持っている経験や知見、ノウハウを犠牲にしてまで、ビッグデータの分析に依存する方向に社会に広がり始めている、という指摘である。

指摘の内容は、ビッグデータの到達しようとしているゴールは、データ分析の手法を"単純か"し、それを高速、かつ大量に処理する事が出来る、という点であるにも関わらず、まるで人間の能力を超えた高度な知識をもったソリューションとして扱う様な動きが見え始めている、という懸念である。この記事の作者である、Steve Lohr氏は、データ分析技術者という者は、決して人間の知識や経験を置き換える様な役割を持っているのではなく、単純にMapReduceのコードを書く事が出来る技術者である、という事をよく認識すべきである、と述べている。

ロボット工学に近い考え方を適用すべき、とも述べている。ロボットは、人間の行う作業を人間が到底行う事が出来ない速度と精度で行う事が出来るが、決して人間の高度な判断力を置き換える者ではない、という事である。

ビッグデータの活用の方法も、それをよく考慮し、導入する際も企業内の業務の中でも高速か、大量処理化を実現する工程には組み込みつつも、最終的な事業判断に於いては必ず人間の知見、経験を活かした上で結論を出すプロセスを通る事を主張している。

マシンに重たい仕事を任せる

最近この辺の問題が表面化した事例を紹介する。とあるイギリスの大学では、自然言語とマシンラーニングを利用したメディアリサーチの事例を紹介しているが、大量のニュース記事を人間がすべて読破しなくても、こういった技術を利用する事で全体の動向を分析する事が可能である事を研究している。ただし、この研究でも明らかになった事は、最終的に 分析の結果を理解し、わかりやすい分析結果を導きだすのは、研究者自身の判断である、という事であり、決してシステムの判断に依存している訳ではない。


とある法律事務所のケースでは、Recommind社の事例が紹介されている。このベンダでは、e-Discoveryの様な、弁護士が各々のケースで調査を行わなければいけない、何テラバイトもの情報を自動的に分析し、弁護士の作業効率を大幅にアップするPredictive Codingと呼ばれるソリューションを提供している。例えば、特定の裁判に関連するeメール、PDF、等をすべて網羅し、裁判に必要な情報の抽出を行っているが、その作業は、人間の行うより遥かに早い速度で処理を行う一方、やはり人間が介在した最終判断は必須である、と強調している。それだけ、人間の判断は、単なる機械的なBI嶽ではない高度な処理が存在し、まだそれは機械化出来ない時代である、という事である。


BeyondCoreというソフトウェア製品があるが、これも人間の独特な判断力を支援するBIツールであるが、最終的には人間の判断を支援するためのツールであることには変わらない。このツールの場合は人間が介在するプロセスは、最初の母体データのデータ設定、各種データの相関関係や条件を設定するステップ、さらに、最後のステップである分析結果を見て最終的な判断を下す段階である。その間のプロセスは、BeyondCoreのLucidと呼ばれるエンジンがデータを深いレベルまで解析し、下記の様な相関関係図を表示し容易な判断を下せる様なデータ表示モデルを展開する。


顧客動向マーケティングの専門ベンダーである、ClickFox 社のCEO, Marco Pacelli氏は、この考え方を下記のように述べている。

「部屋の明かりがパッとついた時に、部屋にゴキブリが数匹発見される状況を考えてほしい。BigData分析は、ゴキブリを映し出す電気の役割。しかし、どのゴキブリを殺すかを決めるのは人間であるCEOの仕事。」

逆に、ビッグデータを導入する際には、改めて最終事業判断を迅速に行う事が出来るのかどうか、会社の中で見極める事の重要性を強調している。

問題を見つけたとしても、その対策を即座に行わなければ何もしないのと同じ、という事である。

アルゴリズムは決して人間を超えない

これらの例は、さらに実際にInternet上に存在するビッグデータの置かれている状況においては、さらに異なる取り組みを強要される。Eli Pariser氏の著作、"The Filter Bubble:  What the Internet Is Hiding From You." によると、インターネットに存在するサーチエンジンの裏にある広告事業に利用されるユーザプロファイル分析エンジンのアルゴリズムは、あまりにも単純で、人間が本来期待すべき高度な賢さが無く、我々の生活にさほど役立っていない、と主張している。確かにメールボックスに入ってくする広告メールは的を得ていない物も非常に多い。

こんな中で、人間はいつの間にかインターネットという物の持つ知識レベルを課題評価しているのでは、と感じる。考えてもみれば、インターネット上に存在する様々なアプリケーション(AWS, Instragram他)という物は、膨大な数のユーザに対して、かなり標準的なサービスを、 カスタマイズ出来ない条件で提供するモデルに徹しており、決してきめ細かい、という表現は出来ないはずである。

特にセキュリティや、信頼性、等ユーザの要求レベルの差異が大きい要求に対して、インターネットアプリがあまり対応出来ていない、というのはこういう背景がある、と考えるとごく自然に理解出来るはず。

人間とITを上手に融合する方法

最も理想的なモデル、というのは今後も発展を遂げて行くと期待されるが、当面は、ITによるデータ分析、そして人間による高度な判断力を組み合わせたソリューションがベストプラクティスになっていくもの、と想定される。コンシューマ向けの広告事業であろうと、企業内の事業判断を決めるプロセスに於いても、共通しているテーマである、と言える。

ビッグデータの可能性は、如何に人間が最終的に施す判断を迅速、そしてきめ細かにする事が出来る自動化の機能にある、と言える。ビッグデータの導入においては、この事をよく理解した上で戦略を策定する事が成功につながる、と言える。

Ippei Suzuki
tel:  (714) 930-5000
Twitter = CloudNewsCenter
Skype = ippei.suzuki